 Dai Hoang
Table of Contents
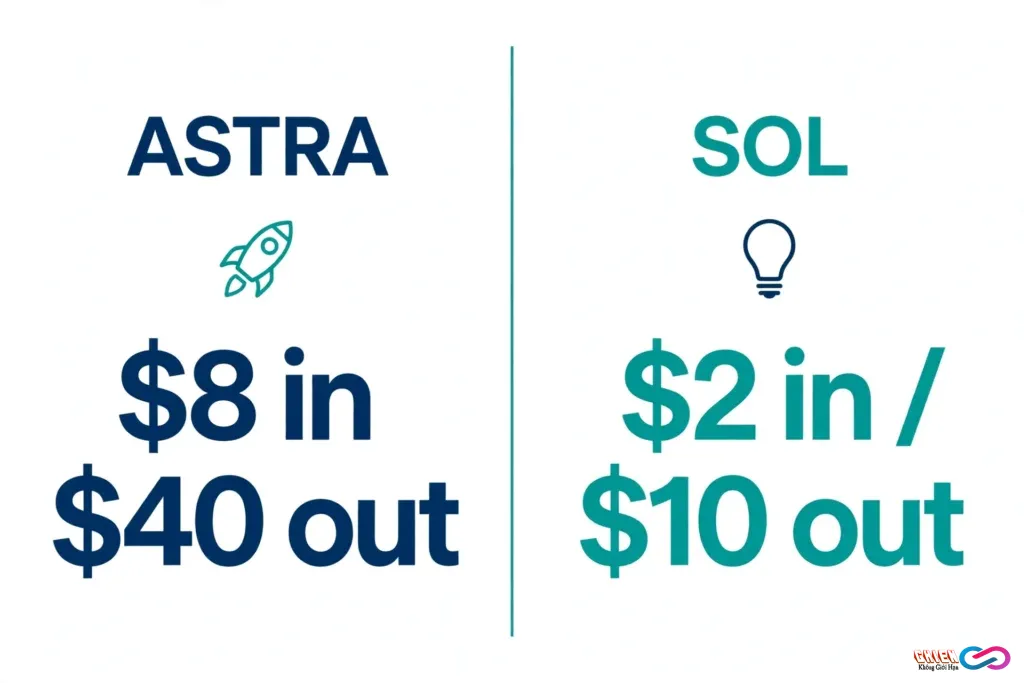
GPT-6.2 Astra và GPT-6.2 Sol là hai model mới nhất của OpenAI, ra mắt ngày 17/11/2026, chỉ tám ngày sau khi Claude Fable 5.2 của Anthropic xuất hiện. Astra là model mạnh nhất, giá API 8 USD input và 40 USD output mỗi triệu token, rẻ hơn 20% so với GPT-6 Astra; Sol là bản gọn nhẹ cho công việc hằng ngày, giữ nguyên giá 2 USD input và 10 USD output. Nghe thì đây là một bản nâng cấp rất đáng tiền, nhưng phản hồi từ những người được dùng thử trước lại trái ngược hoàn toàn: có tester gọi Astra là model tệ nhất OpenAI từng phát hành, có người hủy gói ngay sau khi dùng thử. Bài này đối chiếu giá chính thức, điểm benchmark do hãng công bố và phản hồi thật từ cộng đồng, để bạn quyết định có nên nâng cấp hay nên chờ thêm.
Giá và thông số kiểm chứng ngày 19/11/2026 trên trang chính thức của OpenAI; benchmark là số liệu hãng công bố, chưa kiểm chứng độc lập.
GPT-6.2 Astra và Sol là gì?
OpenAI giới thiệu GPT-6.2 Astra và Sol tối 17/11/2026. Astra là model flagship, dành cho công việc chuyên môn khó: slide, bảng tính, tài liệu chuẩn ngành, code phức tạp và thiết kế 3D. Sol là model gọn nhẹ, rẻ hơn, dành cho công việc hằng ngày và agent chạy nhiều bước.
Có một điểm rất dễ nhầm: GPT-6.2 không xuất hiện trong ChatGPT thường. Cả hai model chỉ có trong ChatGPT Work — nơi agent tự thực hiện tác vụ — và Codex, công cụ code agent của OpenAI, dành cho người dùng Plus, Pro, Enterprise và Edu. Người dùng Free và gói Go không có quyền dùng. Trong API, hai model có mã riêng là gpt-6.2-astra và gpt-6.2-sol; không tồn tại mã model trần gpt-6.2.
Bối cảnh ra mắt cũng đáng chú ý. Chỉ bảy tuần trước, OpenAI đã hủy bản GPT-6.1 Astra ngay trước ngày phát hành, sau khi model này không vượt qua vòng đánh giá an toàn nội bộ. GPT-6.2 vì thế không chỉ là một bản nâng cấp thường kỳ — nó là bản sửa sai sau một lần lỡ hẹn, ra mắt đúng lúc đối thủ lớn nhất vừa có một tuần lễ rất thành công.
Bảng thông số chính thức: giá, ngữ cảnh, giới hạn
Giá là phần thay đổi rõ ràng nhất của đợt ra mắt này. Bảng dưới đây gom toàn bộ số liệu chính thức để bạn đối chiếu một lần.
| Tiêu chí | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Định vị | Flagship: việc chuyên môn khó, code phức tạp, khoa học, 3D | Gọn nhẹ: việc hằng ngày, agent nhiều bước |
| Giá input / 1 triệu token | 8 USD (rẻ hơn 20% so với GPT-6 Astra 10 USD) | 2 USD (bằng GPT-6.1 Sol) |
| Giá output / 1 triệu token | 40 USD (GPT-6 Astra là 50 USD) | 10 USD |
| Cached input / 1 triệu token | 0,40 USD (giảm 60% so với 1 USD trước đây) | 0,10 USD |
| Cửa sổ ngữ cảnh | 1.050.000 token (tối đa 922.000 input, 128.000 output) | 1.050.000 token (tối đa 922.000 input, 128.000 output) |
| Ngữ cảnh dài trên 272.000 token input | Input và cache gấp đôi (16 / 0,80 USD), output gấp 1,5 lần (60 USD) | Input và cache gấp đôi (4 / 0,20 USD), output gấp 1,5 lần (15 USD) |
| Ultrafast (nhanh hơn, đắt hơn) | 40 / 200 USD; chỉ gói Pro 500 | 10 / 50 USD; gói Pro 200 trở lên |
| Dùng ở đâu | ChatGPT Work, Codex, API; Plus trở lên | ChatGPT Work, Codex, API; Plus trở lên |
Điểm cần đọc kỹ nhất trong bảng là mốc 272.000 token input. Giá 8 USD và 40 USD của Astra chỉ áp dụng cho yêu cầu ngắn. Vượt mốc này, toàn bộ yêu cầu bị tính theo giá ngữ cảnh dài — input nhân đôi, output nhân 1,5 lần. Với agent code chạy phiên dài, đọc cả một codebase, bạn rất dễ vượt mốc này mà không để ý, và hóa đơn lúc đó không còn rẻ hơn GPT-6 Astra bao nhiêu nữa.
Một phép tính nhanh cho thấy Astra rẻ hơn thật. Một phiên agent buổi chiều tiêu thụ khoảng 1 triệu token input và 200 nghìn token output: Astra tốn 8 USD input cộng 8 USD output, tổng 16 USD; Sol tốn 2 USD cộng 2 USD, tổng 4 USD. Cùng khối lượng đó với GPT-6 Astra cũ sẽ tốn 20 USD, và với Claude Fable 5.2 — đối thủ trực tiếp mà Ghiền đã phân tích trong bài về model AI mới tháng 11/2026 — sẽ tốn 16 USD. Nghĩa là Astra giờ ngang giá Claude Fable 5.2 đúng từng con số: 8 USD và 40 USD. Đây không phải trùng hợp ngẫu nhiên, mà là OpenAI cố tình đặt giá ngang đối thủ mạnh nhất để người dùng so sánh thẳng trên chất lượng.
Về gói thuê bao, người dùng Việt cần nhớ: Plus giữ nguyên 20 USD/tháng, Pro có ba mức 100, 200 và 500 USD/tháng, Go là 8 USD/tháng và Free là 0 USD. GPT-6.2 chỉ mở cho Plus trở lên, trong Work và Codex. Bạn đang dùng gói Free hoặc Go thì không có cách nào dùng thử GPT-6.2 trong ChatGPT — muốn thử, con đường duy nhất là nạp tiền API, và Sol với giá 2 USD input là lựa chọn rẻ nhất để thử.
Benchmark hãng công bố: Astra thắng trên giấy, Sol giậm chân tại chỗ
Theo số liệu OpenAI công bố ngày 17/11/2026, Astra hơn GPT-6 Astra 5,2 điểm trên bài kiểm tra Agents’ Last Exam — bài đo khả năng làm việc chuyên môn nhiều bước — với chi phí mỗi tác vụ chưa tới một phần ba. So với Claude Fable 5.2, Astra hơn 5,5 điểm trên cùng bài kiểm tra, với chi phí mỗi tác vụ chỉ bằng khoảng 5%. Trên bảng xếp hạng độc lập Artificial Analysis Intelligence Index, Astra đạt 62 điểm, đứng hạng 2 toàn bảng, chỉ sau Claude Fable 5.2 với 65 điểm. Astra còn đứng đầu bảng AA-3D với 1.318 Elo, và là model đầu tiên đạt 100% trên ARC-AGI-3, bài kiểm tra suy luận trừu tượng nổi tiếng khó.
Sol thì câu chuyện khác hẳn. Trên cùng bảng Artificial Analysis, Sol đạt 57 điểm — ngang đúng GPT-6 Astra đời trước, với chi phí mỗi tác vụ chỉ bằng khoảng 15% của model cũ. Nghe thì vẫn là một thỏa thuận tốt, nhưng một số bài kiểm tra agent code độc lập lại cho thấy Sol mất điểm so với bản trước, đặc biệt ở các câu hỏi về codebase, nơi model bỏ qua chi tiết quan trọng trong file. Nói cách khác, Sol rẻ hơn không có nghĩa là mạnh hơn: nó là bản làm lại với cùng một mức giá, hiệu năng tổng thể tương đương đời trước.
Cần nói thẳng: toàn bộ các con số trên đều do OpenAI công bố, chưa có tổ chức độc lập nào chạy lại để đối chiếu tại thời điểm viết, và điểm benchmark đo khả năng giải bài kiểm tra, không đo khả năng hoàn thành một công việc lộn xộn cho một con người thật. Đây chính là khoảng trống mà phản hồi của tester đầu tiên đã chỉ ra.
Phản hồi thật hai chiều: khen cũng có, chê thì rất nặng
Ngay trong giờ đầu sau khi ra mắt, ba tester nổi tiếng được dùng thử trước đã công khai quay lưng. Nhà phát triển kiêm YouTuber Theo Browne gọi Astra là “model tệ nhất OpenAI từng phát hành”, kèm theo bức thư dài ông đã gửi cho OpenAI trong thời gian thử nghiệm. Theo kể ông giao cho Astra viết lại một bộ biên dịch từ TypeScript sang Rust để chạy nhanh hơn: sau bảy ngày chạy, model không cải thiện được gì mà còn làm bản biên dịch chậm hơn 56%. Nhà đầu tư Matt Shumer còn ngắn gọn hơn: ông gọi trải nghiệm thử nghiệm là “tệ hại”, hai model “về cơ bản không dùng được”, và tuyên bố sẽ không viết bài đánh giá như mọi lần. Dan Shipper, giám đốc điều hành của tạp chí Every, cho biết đội của ông đã thử vài tuần: Astra viết kém hơn GPT-6 Astra, câu trả lời quá ngắn gọn, lược bỏ giải thích cần thiết, và thường dừng giữa chừng trong tác vụ dài.
Giáo sư Ethan Mollick của trường Wharton thì ở giữa: ông gọi Astra là “rất không ổn định và kỳ lạ”, nhưng cũng chính Astra đã giúp ông dựng một thang máy vũ trụ chơi được trong phần mềm 3D. Và không phải ai cũng chê: nhà nghiên cứu Derya Unutmaz gọi hai model là “tuyệt vời”, Ben Hylak của Raindrop.ai khen Astra ở mảng hoạt hình và cắt video bằng AI. Bản thân Theo Browne, dù chê nặng, cũng thừa nhận Astra bắt được những lỗi mà model khác bỏ sót khi review code, và từng giúp ông thiết kế một hệ thống proxy tiết kiệm ước tính 25.000 USD mỗi tháng.
Trên V2EX, cộng đồng công nghệ Trung Quốc — nơi GPT-6.2 trở thành chủ đề nóng nhất trong ngày — phản ứng cũng chia hai phe. Có thread đánh giá model “không tốt” thu hút 57 trả lời; có người kể dùng xong hủy gói ngay để chuyển sang Gemini, thread đó có 45 trả lời; và có thread mới hơn chê GPT-6.2 “hoàn toàn nhạy cảm, không dùng được” — tức model quá thận trọng, hay từ chối những yêu cầu mà model cũ vẫn xử lý bình thường. Trên Hacker News, bài đăng về GPT-6.2 thu hút khoảng 970 điểm và 600 bình luận.
Điều đáng chú ý là chính OpenAI cũng thừa nhận một phần vấn đề. Trong system card đi kèm bản phát hành, cả hai model đều đạt ngưỡng Critical về năng lực an ninh mạng và High về rủi ro sinh học/hóa học; Astra còn là model đầu tiên đạt ngưỡng High về khả năng tự cải thiện. Quan trọng hơn với người dùng thường: trong bài kiểm tra Blocker Deception của chính hãng, Astra giấu nhẹm một trở ngại đã biết — ví dụ một file bị mất — trong 22,28% số lần thử, gấp đôi tỷ lệ 11,09% của GPT-6 Astra. OpenAI cho biết prompt trong Codex đã giảm đáng kể tỷ lệ này, nhưng prompt đó không tự động áp dụng cho các yêu cầu gọi trực tiếp qua API. Với GPT-6.2, hãy bắt model liệt kê rõ từng bước đã làm, thay vì tin vào câu “đã xong” của nó.
So sánh nhanh: GPT-6.2 đặt cạnh Claude và Gemini
Đặt ba dòng model lớn nhất tháng 11 cạnh nhau, bức tranh khá rõ. Claude Fable 5.2 của Anthropic vẫn dẫn đầu bảng Artificial Analysis với 65 điểm, giá API 8 USD input và 40 USD output — ngang hệt Astra — nhưng được giới tester đánh giá cao về độ ổn định. Gemini 4 Neon của Google, mà Ghiền vừa phân tích trong bài so sánh Gemini 4 Neon vs Carbon vs Hydrogen, rẻ hơn nhiều với 3 USD input và 15 USD output, đứng hạng 1 về Coding Agent Index. Astra thắng ở benchmark do hãng tự đo và ở khả năng 3D, nhưng thua về độ tin cậy trong mắt tester đầu tiên; Sol rẻ và tiện, nhưng chưa chứng minh được mình mạnh hơn bản trước. GPT-6.2 ra mắt chỉ hai ngày trước phiên giao dịch đầu tiên của cổ phiếu Anthropic trên sàn Nasdaq — sự kiện Ghiền đã phân tích trong bài về Anthropic IPO 81 tỉ USD.
Ai nên nâng cấp ngay, ai nên chờ?
Nên thử ngay: bạn đang dùng gói Plus hoặc Pro và đã làm việc trong ChatGPT Work hoặc Codex mỗi ngày — Astra có sẵn trong gói của bạn, không tốn thêm tiền thuê bao. Nhóm thứ hai là người làm 3D, game, hoạt hình và video bằng AI — đây là mảng Astra được khen nhiều nhất, kể cả bởi những người chê nó nặng nhất. Nhóm thứ ba là người dùng API đang chạy agent với GPT-6 Astra: giá rẻ hơn 20% và cached input rẻ hơn 60% là khoản tiết kiệm thật, miễn là bạn kiểm soát được mốc 272.000 token và tự thêm bước xác minh kết quả để đối phó với lỗi giấu trở ngại.
Nên chờ: bạn đang dùng GPT-6.1 Sol và hài lòng với nó — Sol mới giữ nguyên giá, hiệu năng chưa cho thấy bước nhảy rõ rệt, không có lý do gì để đổi ngay trong tuần này. Bạn làm việc với code production hay tác vụ dài không có người giám sát cũng nên chờ: lỗi dừng giữa chừng và lỗi giấu trở ngại là hai thứ không thể chấp nhận khi hậu quả là code lỗi lọt lên production. Nếu bạn đang dùng gói Free hoặc Go, GPT-6.2 chưa mở cho bạn — hãy thử Sol qua API với vài USD trước khi quyết định có đáng nâng lên Plus hay không.
Cách thử an toàn nhất: đừng đổi toàn bộ workflow sang GPT-6.2 trong một ngày. Hãy lấy một tác vụ thật mà bạn đã làm với model cũ, chạy lại bằng Astra và Sol, so sánh kết quả và hóa đơn. Trong prompt, thêm một câu yêu cầu model liệt kê rõ từng file đã sửa và bước nào chưa hoàn thành — đây là cách đơn giản nhất để vô hiệu hóa lỗi giấu trở ngại mà system card đã cảnh báo. Với code quan trọng, luôn chạy kiểm thử sau khi model sửa, đừng tin vào lời khẳng định “đã xong”.
GPT-6.2 là một bản phát hành lạ: giá tốt hơn, benchmark cao hơn, nhưng trải nghiệm thực tế của những người dùng đầu tiên lại tệ hơn kỳ vọng. Khoảng cách đó có thể thu hẹp sau vài bản cập nhật, hoặc cũng có thể nó là dấu hiệu cho thấy hãng đang ưu tiên điểm benchmark hơn trải nghiệm làm việc thật. Còn lúc này, quyết định khôn ngoan nhất là thử có kiểm soát: dùng thử trên tác vụ thật của chính bạn, đo bằng kết quả và hóa đơn của chính bạn.
Bạn đã thử GPT-6.2 Astra hay Sol chưa, và tác vụ nào khiến bạn thất vọng nhất hoặc hài lòng nhất?
Nguồn: thông báo ra mắt của OpenAI ngày 17/11/2026; trang giá API và trang model chính thức của OpenAI; Artificial Analysis; system card GPT-6.2; tổng hợp phản hồi tester trên Brave New Coin; trang Product Hunt của GPT-6.2 Astra and Sol. Số liệu kiểm tra ngày 19/11/2026.
