 Dai Hoang
Table of Contents
Một công ty vừa cấm toàn bộ việc dùng AI sinh code trực tiếp, quay về viết tay, sau hai sự cố: code AI chưa review kỹ lọt lên hệ thống thật khiến người dùng phàn nàn hàng loạt, và một câu lệnh xóa dữ liệu do AI sinh ra đã xóa nhầm cả dữ liệu người dùng đang hoạt động. Câu hỏi đáng hỏi là quy trình review và kiểm thử của công ty đó đã bỏ qua những khâu nào — và có một chi tiết còn sai ngay từ gốc: sự cố sập hệ thống của Microsoft mà lãnh đạo công ty đổ cho “vibe coding”, theo chính Microsoft, không liên quan gì tới AI.
Tôi đã từng ngồi review một đoạn code do AI viết ra, dài gần 400 dòng, cho một tính năng tưởng như đơn giản: dọn dữ liệu người dùng không còn hoạt động. Nhìn qua thì mọi thứ đều ổn, cho tới khi đọc tới dòng điều kiện lọc, tôi mới thấy nó đang chọn sai tập người dùng: điều kiện “không hoạt động” được định nghĩa bằng lần đăng nhập cuối, mà hệ thống của chúng tôi lại có cả một nhóm người dùng chỉ dùng ứng dụng qua API, không bao giờ đăng nhập. Chạy đoạn code đó lên hệ thống thật là xóa nhầm đúng nhóm người dùng đang trả tiền đều đặn nhất. Lỗi đó không nằm ở AI — nó nằm ở chỗ nếu hôm đó tôi bận và bấm merge cho qua, không ai khác kiểm tra lại. Câu chuyện ở công ty trong bài này giống hệt như vậy, chỉ khác là không ai chặn lại kịp.
Chuyện gì đã xảy ra: hai sự cố, một lệnh cấm
Câu chuyện được một lập trình viên kể lại trên diễn đàn V2EX, trong thread đăng ngày 19/11/2026 và nhanh chóng leo lên đầu mục hot với hơn 10.000 lượt xem và hơn 140 trả lời chỉ trong vài giờ. Công ty không được nêu tên — bài này kể lại đúng khung “một lập trình viên kể”.
Sự cố thứ nhất: một đồng nghiệp dùng AI sinh code cho một tính năng, nhưng khâu rà soát làm không kỹ. Code lên hệ thống thật, gây lỗi, nhiều người dùng phàn nàn. Bài đăng không nói rõ lỗi đó là lỗi gì — chỉ biết nó đủ lớn để cả phòng phải nhìn lại cách mình làm việc.
Sự cố thứ hai: một đồng nghiệp khác cần xóa dữ liệu người dùng không còn hoạt động, nhờ AI sinh câu lệnh xóa. Câu lệnh chạy xong mới phát hiện nó xóa luôn cả một phần dữ liệu của người dùng đang hoạt động. Người kể giải thích thêm: thực ra không phải một câu SQL đơn lẻ, mà là logic xóa nằm trong code ORM, logic phức tạp và liên quan tới nhiều nghiệp vụ — nên lúc review đã bị bỏ sót.
Hai sự cố đó, cộng thêm một yếu tố thứ ba, đã đủ để lãnh đạo công ty mất niềm tin hoàn toàn. Quy định mới: AI chỉ được dùng để phân tích và đề xuất phương án, nghiêm cấm sinh code trực tiếp. Công ty cắt luôn hạn mức token cấp cho nhân viên, ai muốn dùng AI để viết code thì phải tự bỏ tiền túi mua model mạnh. Tiến độ được nới ra đôi chút, nhưng theo người kể thì vẫn chưa đủ so với thời gian viết tay thật sự cần.
Phản ứng của cộng đồng trong thread gần như nghiêng hẳn về một phía: đa số cho rằng đây là lỗi quy trình, không phải lỗi AI. Người viết code bằng tay thì không gây lỗi chắc? Code nào cũng phải qua review và kiểm thử mới được lên hệ thống thật, dùng công cụ gì để viết cũng vậy. Có người ví von: giống như có người dùng dao làm bị thương người khác rồi đòi cấm toàn bộ dao trong bếp. Một bình luận khác chua hơn: AI không tự lén xóa dữ liệu, cũng không tự lén đẩy code lên hệ thống thật — có người bấm nút chạy và bấm nút merge, và chính những cái bấm nút đó không được kiểm soát.
Cú “đổ thêm dầu”: sự cố Microsoft có thật sự do vibe coding?
Yếu tố thứ ba là chi tiết đáng chú ý nhất, vì nó cho thấy lệnh cấm được ban ra trên một tiền đề sai. Theo người kể, lãnh đạo công ty cho rằng sự cố sập hệ thống gần đây của Microsoft cũng do “vibe coding” gây ra, và đó là giọt nước cuối cùng khiến ông mất niềm tin vào AI Coding.
Sự cố đó có thật: từ ngày 12/11/2026, Microsoft 365 — gồm Outlook, Exchange Online, Teams, SharePoint — sập trên diện rộng hơn 24 giờ, ảnh hưởng tới người dùng ở hơn 70 quốc gia. Nhưng nguyên nhân thì không phải như vị lãnh đạo kia nghĩ. Trong tuyên bố ngày 13/11/2026, Microsoft khẳng định sự cố là “vấn đề kỹ thuật không liên quan tới tấn công mạng hay AI / agent”. Báo cáo sơ bộ ngày 16/11/2026 của hãng chỉ ra ba nguyên nhân cộng hưởng: một lỗi tiềm ẩn từ bản vá tháng 7/2026 khiến máy chủ gateway mạng bị quá tải, lưu lượng Teams bất ngờ dồn về cùng gateway với Exchange Online, và khoảng 14% máy chủ gateway đang tạm ngừng hoạt động vì một vấn đề khác. Không có bằng chứng nào gắn sự cố này với code do AI viết.
Hai sự cố nội bộ là thật, và cảm giác mất kiểm soát khi code được sinh ra quá nhanh là có thật. Nhưng khi một quyết định cấm đoán được xây trên ba lý do mà một trong ba đã được chính hãng liên quan bác bỏ công khai, thì quyết định đó đáng được xem lại từ đầu.
Hai sự cố, một gốc chung: tốc độ sinh code vượt tốc độ kiểm chứng
Nếu bóc tách cả hai sự cố, điểm chung không nằm ở AI mà nằm ở một chỗ: tốc độ sinh code đã vượt xa tốc độ kiểm chứng của đội ngũ đó. Chính người kể chuyện cũng thừa nhận điều này trong phần bổ sung của thread: nút thắt lớn nhất của công ty hiện nằm ở khâu kiểm thử. Vibe coding có thể sinh ra một tính năng rất nhanh, nhưng đội kiểm thử không thể “vibe” để tiêu hóa lượng yêu cầu đó với cùng tốc độ. AI tự review code của chính mình thì không đáng tin, còn con người review hàng loạt code AI sinh ra thì vừa mệt, vừa dễ bị một chú thích hợp lý đánh lừa.
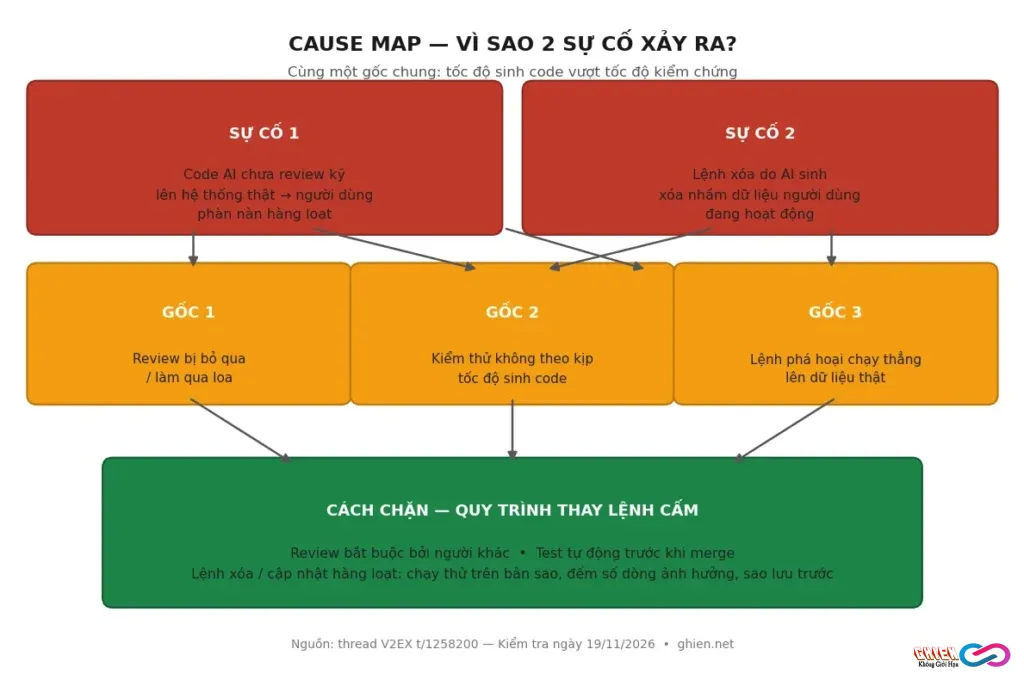
Nhìn vào sơ đồ, mỗi sự cố đều đi qua ít nhất hai lớp phòng thủ bị bỏ trống trước khi chạm tới người dùng thật. Sự cố code lỗi: AI sinh code → review qua loa → không có kiểm thử đủ bao phủ → lên hệ thống thật. Sự cố xóa nhầm dữ liệu: AI sinh logic xóa trong ORM → review bỏ sót điều kiện lọc phức tạp → câu lệnh chạy thẳng lên dữ liệu thật, không qua bản sao, không có bước khôi phục. Trong cả hai chuỗi, AI chỉ đứng ở đầu chuỗi.
Viết tay cũng từng gây ra đúng những sự cố này, chỉ là chậm hơn: trước đây một tính năng mất cả buổi mới viết xong, nên đội review và test có cả buổi để theo kịp. Giờ AI sinh xong trong vài phút, mà quy trình kiểm chứng vẫn chạy với tốc độ cũ.
Con số bên ngoài câu chuyện: code nhiều hơn, nhưng release không tăng theo
Cảm giác “nhanh nhưng không chắc” này không chỉ là cảm nhận của một công ty. Một bài tổng hợp nghiên cứu đăng trên dev.to ngày 18/11/2026 cho thấy bức tranh phức tạp hơn hẳn khẩu hiệu “AI giúp code nhanh hơn”. Nghiên cứu của các nhà kinh tế MIT và Wharton (bản sửa tháng 9/2026) trên hơn 500.000 lập trình viên GitHub ước tính: sau khi dùng agent code tự động, hoạt động commit tăng tới 240%, nhưng số bản phát hành phần mềm chỉ tăng 30%.
Các nghiên cứu về tốc độ cá nhân cũng cho kết quả trái chiều: một nghiên cứu đăng trên Management Science (2026) ghi nhận lập trình viên hoàn thành nhiều hơn 26,08% nhiệm vụ khi có AI hỗ trợ; nhưng thí nghiệm của METR (tháng 7/2025) lại thấy lập trình viên có kinh nghiệm chậm hơn 19% khi dùng AI.
Đọc chung các con số này, kết luận hợp lý không phải là “AI vô dụng” hay “AI thần thánh”, mà là: AI đang làm tăng mạnh lượng code được tạo ra, nhưng phần việc biến code đó thành sản phẩm chạy ổn định — review, test, sửa lỗi, phát hành — không tăng theo cùng tốc độ.
| Sự cố | Khâu bị bỏ qua | Cách chặn rẻ nhất |
|---|---|---|
| Code AI chưa review kỹ lên hệ thống thật | Review qua loa; test không đủ bao phủ | Review bởi người khác + test tự động trước khi merge |
| Lệnh xóa do AI sinh xóa nhầm dữ liệu đang hoạt động | Điều kiện lọc trong ORM bị bỏ sót; chạy thẳng trên dữ liệu thật | Chạy thử trên bản sao, đếm số dòng ảnh hưởng, sao lưu trước khi xóa |
| Lãnh đạo mất niềm tin vì sự cố Microsoft | Tin tin đồn, không kiểm chứng nguyên nhân chính thức | Đối chiếu tuyên bố của hãng trước khi quyết định |
Thay lệnh cấm bằng quy trình: 6 quy tắc dùng AI an toàn
Cấm hẳn là cách dễ nhất, nhưng cũng là cách tốn kém nhất: tiến độ chậm lại, nhân viên quay về viết tay trong khi đối thủ vẫn dùng AI, và một quy định khó thực thi — không ai chứng minh được một đoạn code là do người viết hay AI viết. Dưới đây là quy trình thay thế, đúc kết từ chính những gì cộng đồng trong thread đề xuất.
1. Phân loại code theo mức rủi ro, không cấm đồng loạt. Code giao diện, script xử lý dữ liệu một lần, code kiểm thử tự động — cứ để AI viết, review nhanh là đủ. Code chạm tới tiền, dữ liệu người dùng, xác thực và phân quyền — bắt buộc review kỹ bởi người có kinh nghiệm, bất kể code đó do ai viết.
2. Review bằng phiên làm việc mới, model khác nếu có thể. AI tự review code của chính mình thường rơi vào bẫy “tự thấy hợp lý”: nó đọc chú thích của mình rồi kết luận logic bên dưới cũng đúng. Cách chặn đơn giản nhất là mở một phiên làm việc mới, đưa code vào và yêu cầu review độc lập — tốt hơn nữa là dùng một model khác. Với logic phức tạp, người review phải đọc logic thật, không đọc chú thích.
3. Lệnh phá hoại không bao giờ chạy thẳng lên dữ liệu thật. Đây là quy tắc cứng: mọi câu lệnh xóa, cập nhật hàng loạt hay migration thay đổi dữ liệu đều phải chạy thử trên bản sao trước, in ra số dòng sẽ bị ảnh hưởng để con người xác nhận, và chỉ chạy thật sau khi đã sao lưu. Nếu đội của bạn chưa có staging tách biệt với dữ liệu thật, thì đó mới là thứ cần đầu tư trước tiên.
4. Giới hạn quyền của agent, mặc định chỉ đọc. Agent viết code chỉ nên có quyền đọc repo và đề xuất thay đổi; mọi thao tác ghi, chạy lệnh, deploy đều cần con người phê duyệt từng bước. Quyền hạn càng hẹp, hậu quả của một lần AI “hiểu sai” càng nhỏ.
5. Test tự động là cửa bắt buộc trước khi merge. Code AI sinh ra nhanh, nhưng test cũng có thể nhờ AI sinh ra nhanh — vấn đề là phải có test, và test phải chạy. Quy tắc thực tế: không có test đi kèm thì không merge, bất kể code do người hay AI viết. Với tính năng chạm tới dữ liệu, test phải bao gồm trường hợp biên: người dùng vừa đúng ngưỡng “không hoạt động”, người dùng chỉ dùng qua API.
6. Đo lỗi theo nguồn code, thay vì đổ lỗi theo cảm tính. Thay vì cấm vì “cảm thấy AI gây lỗi”, hãy ghi lại trong vài tuần: mỗi lỗi lên hệ thống thật thì code đó do AI viết hay người viết, khâu nào đã bỏ qua. Nhiều đội làm vậy rồi mới phát hiện tỉ lệ lỗi của code AI sau khi review kỹ không cao hơn code người viết.
Lệnh cấm giúp lãnh đạo yên tâm ngay lập tức, nhưng gốc rễ — quy trình review và test yếu — vẫn còn nguyên đó. Quy trình an toàn tốn công xây dựng hơn, nhưng nó chặn được cả lỗi do AI lẫn lỗi do người viết tay, vì nó sửa đúng chỗ đã hỏng.
Khi nào thì cấm thật mới là lựa chọn đúng?
Công bằng mà nói, có những bối cảnh mà hạn chế AI là hợp lý: hệ thống liên quan trực tiếp tới an toàn tính mạng, dữ liệu y tế hay bí mật quốc phòng, nơi một lỗi nhỏ cũng không thể chấp nhận; hoặc môi trường pháp lý yêu cầu chứng minh được từng dòng code do con người chịu trách nhiệm viết ra. Nhưng ngay cả khi đó, lệnh cấm cũng cần lý do cụ thể và phạm vi rõ ràng — chứ không phải một lệnh cấm toàn diện ban ra sau hai sự cố, dựa trên một tiền đề về sự cố Microsoft đã bị bác bỏ. Lệnh cấm kiểu cắt token còn đẩy mọi thứ xuống làm lén: người dùng vẫn dùng nhưng không dám nói ra để nhờ review.
Bài học lớn nhất từ câu chuyện này không dành riêng cho công ty đó. Bất kỳ đội nào đang dùng AI để viết code cũng nên tự hỏi: nếu ngày mai AI sinh ra một đoạn code lỗi, quy trình của mình có chặn được nó trước khi chạm tới người dùng thật không? Nếu câu trả lời là không chắc, thì việc cần làm không phải là tắt AI đi, mà là vá lại những mắt xích đã lỏng từ trước khi AI xuất hiện.
Số liệu trong bài kiểm tra ngày 19/11/2026: thread V2EX t/1258200 (hơn 10.000 lượt xem, hơn 140 trả lời); sự cố Microsoft 365 ngày 12/11/2026 theo tuyên bố của Microsoft ngày 13/11/2026 và báo cáo sơ bộ ngày 16/11/2026; nghiên cứu MIT/Wharton trên hơn 500.000 lập trình viên GitHub theo bài tổng hợp trên dev.to ngày 18/11/2026. Câu chuyện về công ty cấm AI Coding được kể lại theo lời một lập trình viên trên V2EX, chưa được xác minh độc lập.
Nguồn tham khảo: thread V2EX “我司全面禁止 AI Coding” · dev.to: Is Coding with AI Actually Faster and Cheaper? · XDA: Microsoft giải thích nguyên nhân sự cố Microsoft 365. Đọc thêm trên Ghien: GPT-6.2 Astra vs Sol: có nên nâng cấp không · Gemini 4 Neon so sánh Neon vs Carbon vs Hydrogen · 7 model MAI mới của Microsoft: rẻ hơn 95%, thật hay chiêu marketing?
Đội của bạn đang dùng AI để viết code thì khâu nào là mắt xích yếu nhất: review, kiểm thử, hay quyền chạy lệnh trên dữ liệu thật?
