 Dai Hoang
Table of Contents
Ngày 20/11/2026, Thinking Machines Lab — công ty AI do Mira Murati sáng lập — phát hành Inkling 2 Mini, một model mở giấy phép Apache 2.0 chỉ nặng khoảng 20GB nhưng đạt điểm benchmark code ngang ngửa các model mở cùng tầm. Điểm khác biệt nằm ở kiến trúc looped transformer: thay vì đi qua mỗi lớp một lần, model chạy lại 12 lớp giữa tới 3 lần cho mỗi token, suy luận sâu hơn mà không cần viết chain-of-thought dài ra ngoài. Số liệu trong bài kiểm tra ngày 21/11/2026 từ trang chính thức của hãng và Artificial Analysis; mọi con số benchmark là do hãng tự công bố, chưa có kiểm chứng độc lập.
Model mở 26B nhưng “nặng” hơn con số 26B
Inkling 2 Mini là model Mixture-of-Experts với 26,4 tỉ tham số tổng, nhưng mỗi token chỉ kích hoạt 3,4 tỉ tham số. Nhờ cơ chế lặp vòng, số tham số hiệu dụng mỗi token lên tới 5,4 tỉ — con số này tính cả việc cùng một trọng số được dùng lại nhiều lần. Model có 24 lớp, chia thành 4 khối, mỗi khối 6 lớp. Hai khối giữa (lớp 7–18) chạy 3 lần cho mỗi token, trong khi khối đầu và khối cuối chỉ chạy một lần.
Cách hãng giải thích khá trực quan: các lớp đầu và cuối chủ yếu lo việc dịch chuyển giữa embedding và biểu diễn nội bộ, còn các lớp giữa mới là nơi diễn ra suy luận trừu tượng. Thay vì thêm lớp mới — tức thêm tham số, thêm bộ nhớ — hãng cho các lớp giữa “suy nghĩ lại” thêm hai lượt nữa bằng chính trọng số cũ. Kết quả: 48 lần áp dụng lớp cho mỗi token từ chỉ 24 lớp lưu trữ.
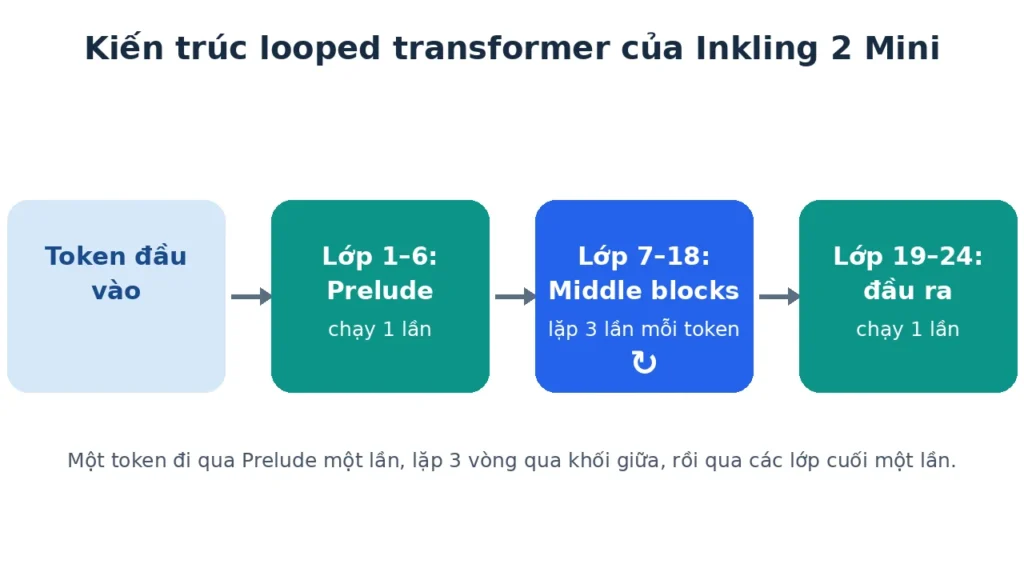
Để việc lặp vòng ổn định trong quá trình huấn luyện, hãng dùng một cơ chế gọi là attention residuals: mỗi lớp đọc đầu ra của các khối trước và tự học cách pha trộn chúng. Mỗi lượt lặp bắt đầu từ đầu ra của khối đầu tiên, đồng thời nhận thêm “tin nhắn” từ lượt lặp trước, trộn vào qua một cổng (gate) mà model tự học trong quá trình huấn luyện. Ban đầu cổng này chặn hoàn toàn tin nhắn cũ — tức mỗi vòng lặp khởi đầu giống hệt model không lặp — rồi dần mở ra theo thời gian.
Một chi tiết kỹ thuật đáng chú ý: phần lớn trọng số của model được huấn luyện và triển khai trực tiếp ở độ chính xác 4-bit NVFP4, 4 lớp cuối dùng MXFP8. Nghĩa là không có bước lượng tử hoá sau huấn luyện gây mất mát chất lượng như thường thấy. Tổng dung lượng checkpoint chỉ khoảng 20GB — đủ nhẹ để chạy ngoại tuyến trên laptop.
Tháng 11 này thị trường model mở liên tục có tin mới: từ Claude Fable 5.2, Gemini 4 tới Kimi K3.1 ra mắt đầu tháng, rồi Gemini 4 Neon của Google giữa tháng. Inkling 2 Mini là cái tên mới nhất chen vào cuộc đua này, nhưng bằng một hướng đi khác hẳn: không đua số tham số, mà đua cách dùng lại tham số cho khôn ngoan hơn.
Benchmark: mạnh nhất ở code, đuối ở kiến thức thuần túy
Theo số liệu hãng công bố trên trang chính thức, Inkling 2 Mini dẫn đầu mọi model mở dưới 100B tham số ở DeepSWE v1.1 với 48,2% và Vals Index v2.2 với 46,5%. Trên Artificial Analysis Intelligence Index, model đạt 20,1 điểm — ngang Qwen3.8-27B, đối thủ cùng tầm được nhắc nhiều nhất — nhưng chỉ dùng khoảng 1/5 số tham số đang hoạt động của Qwen.
Bảng dưới đây so sánh nhanh hai model theo số liệu hãng công bố và Artificial Analysis (kiểm tra ngày 21/11/2026):
| Tiêu chí | Inkling 2 Mini | Qwen3.8-27B |
|---|---|---|
| Tổng / active tham số | 26,4B / 3,4B (5,4B hiệu dụng) | 27B / 27B |
| AA Intelligence Index | 20,1 | 20,1 |
| DeepSWE v1.1 (code) | 48,2% | 42,2% |
| SWE-bench Pro v2 Hard | 77,9% | 73,8% |
| Vals Index v2.2 | 46,5% | — |
| Chi phí mỗi task (AA) | 0,59 USD | 3,53 USD |
| Thời gian mỗi task (AA) | 9,0 phút | 38,2 phút |
| Ngữ cảnh | 1 triệu token | 256K token |
| Giấy phép | Apache 2.0 | Apache 2.0 |
Artificial Analysis còn tính rằng Inkling 2 Mini rẻ hơn khoảng 6 lần và nhanh hơn khoảng 4 lần mỗi task so với Qwen3.8-27B, nhờ dùng ít compute hơn dù tốn nhiều token đầu ra hơn (trung bình khoảng 152K token so với khoảng 110K cho cùng một task). Giá API trên nền tảng Tinker của hãng là 0,15 USD/triệu token input, 0,50 USD/triệu token output và 0,015 USD/triệu token cache hit.
Nhưng có hai điểm yếu hãng tự thừa nhận. Thứ nhất, model không phải mạnh nhất ở chat nhiều lượt hay làm theo hướng dẫn có nhiều ràng buộc: 50,0% trên MultiChallenge và 33,4% trên ComplexConstraints v1.1, đều thua Qwen3.8-27B. Thứ hai, việc lặp vòng giúp suy luận tốt hơn chứ không giúp model nhớ nhiều kiến thức hơn — kiến thức vẫn phụ thuộc vào tổng số tham số. Điểm AA-Omniscience, thước đo tính chính xác về mặt kiến thức, của Inkling 2 Mini chỉ ngang các model cùng cỡ. Bù lại, model dùng search và công cụ rất hiệu quả: dẫn đầu nhóm model mở cùng tầm ở BrowseComp (79,0%), DeepSearchQA (85,3%) và MCP Atlas (82,7%).
Một con số thú vị khác đến từ nhóm nghiên cứu Stanford, đo “trí tuệ trên mỗi joule” — hiệu quả năng lượng trên mỗi truy vấn. Chạy trên NVIDIA DGX Spark, Inkling 2 Mini đạt 0,703, cao hơn hẳn Qwen3.6-35B-A3B (0,430), Gemma-4-26B-A4B (0,159) và Qwen3.5-27B (0,036). Đây là lý do hãng gọi model này là lựa chọn tốt cho việc chạy nhiều agent thường trực trên phần cứng local.
Vì sao “suy nghĩ trong đầu” lại là vấn đề giám sát?
Điểm khiến Inkling 2 Mini được giới nghiên cứu chú ý không chỉ là hiệu năng, mà là hệ quả của chính kiến trúc lặp vòng đối với khả năng giám sát model.
Cách giám sát model phổ biến hiện nay là đọc chain-of-thought (CoT) — phần suy luận model viết ra trước khi trả lời. Cách này hiệu quả một phần vì kiến trúc transformer truyền thống giới hạn số bước tính toán liên tiếp trước khi model buộc phải xuất ra một token. Muốn suy luận dài hơn, model phải viết suy luận ra ngoài, nơi con người đọc được.
Looped transformer phá vỡ giới hạn đó: model làm nhiều tính toán hơn bên trong mỗi token mà không cần viết ra. Suy luận không xuất hiện trong CoT thì bộ giám sát đọc CoT không bắt được. Đây là mối lo đã được nêu ra từ lâu với kiến trúc này, và cũng là lý do Thinking Machines phát hành kèm một biến thể nghiên cứu có số vòng lặp thay đổi được (TML-d24-varloop-research, từ 1 đến 5 lượt) để cộng đồng nghiên cứu.
Kết quả sơ bộ của hãng, công bố cùng ngày phát hành, nhìn chung trấn an: khả năng suy luận không cần CoT của model tăng từ 16 giây (1 lượt) lên 37 giây (3 lượt) theo thước đo Think Fast, nhưng CoT vẫn dễ đọc — ở 5 lượt, CoT ngắn hơn một nửa so với 1 lượt (trung bình 1.661 so với 3.703 token) nhưng độ dài câu và tỉ lệ từ trong từ điển tiếng Anh gần như không đổi. Model cũng gần như không thể cố tình lái CoT của mình theo hướng né tránh giám sát: tỉ lệ làm theo chỉ thị về CoT chỉ 0,1%, thấp hơn cả Qwen3.8-27B (1,3%). Trong thử nghiệm LinuxArena, một model giám sát yếu hơn vẫn bắt được hầu hết các hành vi lén lút, và không thấy xu hướng rõ ràng theo số vòng lặp.
Nói cách khác, ở quy mô này, việc lặp vòng giúp model suy luận sâu hơn nhưng chưa làm nó khó giám sát hơn một cách đáng kể. Hãng cũng thẳng thắn ghi chú rằng kết luận này chỉ đúng ở quy mô hiện tại, và việc theo dõi tính giám sát ở các model lặp vòng lớn hơn vẫn là việc cần làm tiếp.
Chạy local: Mac từ 32GB RAM, DGX Spark, hoặc Ollama
Đây là phần thực tế nhất với người dùng Việt Nam. Theo trang chính thức, Inkling 2 Mini hỗ trợ chạy trên mọi máy Mac có từ 32GB RAM trở lên qua Ollama, chạy hiệu quả trên máy tính AI để bàn NVIDIA DGX Spark nhờ độ chính xác NVFP4 gốc, và có bản GGUF đã lượng tử hoá qua Unsloth và llama.cpp để chạy local. Ngoài ra còn có SGLang, vLLM, NVIDIA Dynamo, TokenSpeed và Llama App cho suy luận mã nguồn mở, cùng SkyRL, Miles và NVIDIA AutoModel cho fine-tuning bằng RL. Toàn bộ trọng số có trên Hugging Face, và model cũng có mặt trên nền tảng Tinker của hãng để suy luận và tuỳ biến, kèm chat trên Tinker Playground.
Quy trình chạy thử nhanh nhất trên Mac:
- Cài Ollama từ trang chính thức, rồi kéo model Inkling 2 Mini về bằng lệnh pull trong terminal. Máy cần tối thiểu 32GB RAM — hãng khuyến nghị 48GB trở lên nếu muốn chạy thoải mái cùng các ứng dụng khác.
- Chạy model bằng lệnh run, sau đó thử ngay một tác vụ code thật: nhờ model sửa một hàm, viết test, hoặc giải thích một đoạn code lạ trong repo của bạn. Đây là thế mạnh lớn nhất của model theo benchmark.
- Nếu muốn dùng model làm agent, hãy gắn thêm công cụ search: điểm BrowseComp và MCP Atlas cho thấy model phát huy tốt nhất khi được tra cứu bên ngoài thay vì chỉ dựa vào kiến thức trong trọng số.
Một lưu ý thực tế: model mạnh về code và tác vụ agent dài hơi, nhưng không phải lựa chọn tốt nhất cho chat trò chuyện nhiều lượt hay làm theo hướng dẫn có quá nhiều ràng buộc. Nếu nhu cầu chính của bạn là trợ lý chat hàng ngày, các model cùng tầm như Qwen3.8-27B vẫn có điểm mạnh riêng. Còn nếu bạn cần một model mở chạy ngoại tuyến trên laptop để code, làm agent, hoặc nghiên cứu kiến trúc looped transformer — Inkling 2 Mini là cái tên đáng thử nhất lúc này. Nếu chưa muốn cài local, có thể thử trước qua API miễn phí của các model khác, ví dụ Gemini 4 Hydrogen có free tier qua API để so sánh trải nghiệm trước khi quyết định.
Nguồn tham khảo: bài công bố chính thức của Thinking Machines và bài phân tích của Artificial Analysis (cả hai đều ngày 20/11/2026), cùng trang model trên Hugging Face.
Bạn sẽ thử Inkling 2 Mini cho tác vụ nào đầu tiên trên máy của mình — code, làm agent tự động, hay chạy thử nghiệm kiến trúc looped transformer?
