 Dai Hoang
Table of Contents
Nghe “cải thiện tới 14%”, nhiều người tưởng GPU AMD sắp chạy nhanh hơn 14%. Không phải vậy. Con số mà OpenAI công bố hôm 18/11 là mức cải thiện tổng hợp của ba chỉ số hiệu năng – điện năng – diện tích (PPA) trên một số khối mạch cụ thể của GPU flagship AMD, so với bản thiết kế mà AMD đã tối ưu rất kỹ từ trước. Điều đáng chú ý hơn con số nằm ở chỗ khác: AMD đã đưa một phần thay đổi do model đề xuất vào thẳng thiết kế gửi đi sản xuất. Đây là lần đầu tiên mã mạch do AI viết được đưa vào silicon thật của một hãng chip lớn.
Bài này đọc kỹ đúng những gì OpenAI công bố, giải thích model sửa chip bằng cách nào, và chỉ rõ phần nào là số liệu đã kiểm chứng, phần nào vẫn chỉ là tuyên bố một phía. Toàn bộ số liệu trong bài được kiểm tra trực tiếp từ bài đăng gốc của OpenAI và thông cáo của Synopsys, ngày kiểm tra 19/11/2026.
OpenAI công bố gì, và vì sao con số 14% gây chú ý
Trong bài đăng kỹ thuật “Advancing chip design with OpenAI models” ngày 18/11/2026, OpenAI cho biết model của hãng đã viết lại mã SystemVerilog RTL — phần mã mô tả mạch điện của chip — cho IP GPU flagship của AMD và đạt mức cải thiện PPA “tới 14%” so với các bản thiết kế nền đã được tối ưu mạnh. OpenAI diễn đạt kết quả này bằng một phép so sánh gây ấn tượng: tương đương “khoảng một năm tiến bộ tối ưu hóa đạt được trong chưa đầy 5 tháng”.
PPA là ba chỉ số mà dân thiết kế chip dùng để chấm một khối mạch: Power (điện năng tiêu thụ), Performance (hiệu năng) và Area (diện tích silicon). Một cải tiến PPA tốt có thể là chạy nhanh hơn với cùng diện tích, hoặc giữ nguyên tốc độ nhưng tốn ít điện và ít diện tích hơn. Điểm quan trọng: 14% là mức cải thiện tổng hợp, OpenAI không tách riêng phần nào thuộc về tốc độ, phần nào thuộc về điện năng hay diện tích, cũng không nói rõ áp dụng cho những khối mạch nào. Vì vậy đừng đọc con số này thành “GPU nhanh hơn 14%”.
Phần khiến giới chip bán dẫn chú ý không phải con số, mà là câu tiếp theo trong bài đăng: “AMD đã đưa một số thay đổi vào một thiết kế gần đây gửi đi sản xuất, và bổ sung các thay đổi khác vào file thiết kế sản xuất để dùng cho các phiên bản sau”. Nói cách khác, mã mạch do model viết không dừng ở phòng thí nghiệm. Nó đã đi vào quy trình sản xuất thật. Bên cạnh GPU, AMD cũng xác minh mức cải thiện PPA “một con số phần trăm” trên các khối chính của CPU flagship thế hệ tiếp theo, dùng thiết kế do model viết.
Bối cảnh đằng sau: OpenAI và AMD đã có thỏa thuận hợp tác đa năm công bố hồi tháng 10/2026, trong đó OpenAI cam kết triển khai tới 6 gigawatt GPU AMD Instinct cho hạ tầng AI của mình, bắt đầu bằng 1 gigawatt GPU MI450 trong nửa cuối 2026. Việc tối ưu thiết kế chip cho AMD vì vậy không phải một dự án phụ — nó gắn trực tiếp với hạ tầng mà chính OpenAI sẽ dùng.
Model sửa chip như thế nào: viết lại RTL rồi kiểm chứng bằng công cụ Synopsys
Để hiểu vì sao chuyện này khác với “AI viết code hộ”, cần biết chip được thiết kế ra sao. Trước khi một con chip được sản xuất, kỹ sư viết mã RTL (Register Transfer Level) bằng ngôn ngữ như SystemVerilog. Mã này mô tả chính xác mạch điện làm gì: tính toán ra sao, dữ liệu di chuyển thế nào, điều khiển ở đâu. Từ RTL, các công cụ EDA (Electronic Design Automation) tổng hợp thành mạch logic, rồi bố trí vật lý trên tấm silicon.
Cách OpenAI làm việc với AMD theo đúng vòng lặp đó, chỉ khác ở người viết mã. Model nhận một khối RTL có sẵn, đề xuất cách viết lại — đổi cách chia pipeline, chia sẻ phần cứng giữa các phép tính, sắp xếp lại logic — rồi dùng công cụ của Synopsys để kiểm tra hai việc: mạch viết lại có giữ đúng hành vi của khối gốc không, và ba chỉ số PPA thay đổi ra sao. Chỉ những bản viết lại vượt qua bước kiểm chứng này mới được tính vào kết quả.
OpenAI mô tả model “suy luận về RTL ở trình độ của một microarchitect chuyên gia” — người thiết kế kiến trúc vi mô, tức người quyết định một khối mạch nên chia thành bao nhiêu tầng pipeline, phép tính nào làm trước, phép nào làm sau. Đây là công việc đòi hỏi kinh nghiệm lâu năm, vì một thay đổi nhỏ ở RTL có thể tiết kiệm diện tích nhưng lại làm chậm xung nhịp, hoặc ngược lại. Model phải cân cả ba chỉ số cùng lúc, chứ không tối ưu một chỉ số rồi phá hai chỉ số còn lại.
Vòng lặp này không mới hoàn toàn. Giới nghiên cứu đã thử dùng AI tối ưu mạch từ lâu, nhưng điểm khác lần này là quy mô và mức độ tin cậy: kết quả được đo trên thiết kế sản xuất thật của AMD, bằng đúng công cụ mà kỹ sư chip dùng hằng ngày, và được chính AMD xác minh rồi đưa vào sản xuất. Trước đây, hầu hết demo AI thiết kế chip chỉ chạy trên mạch mẫu trong phòng thí nghiệm.
Đọc đúng các con số: 14% PPA, 13% và 10% ở Jalapeño
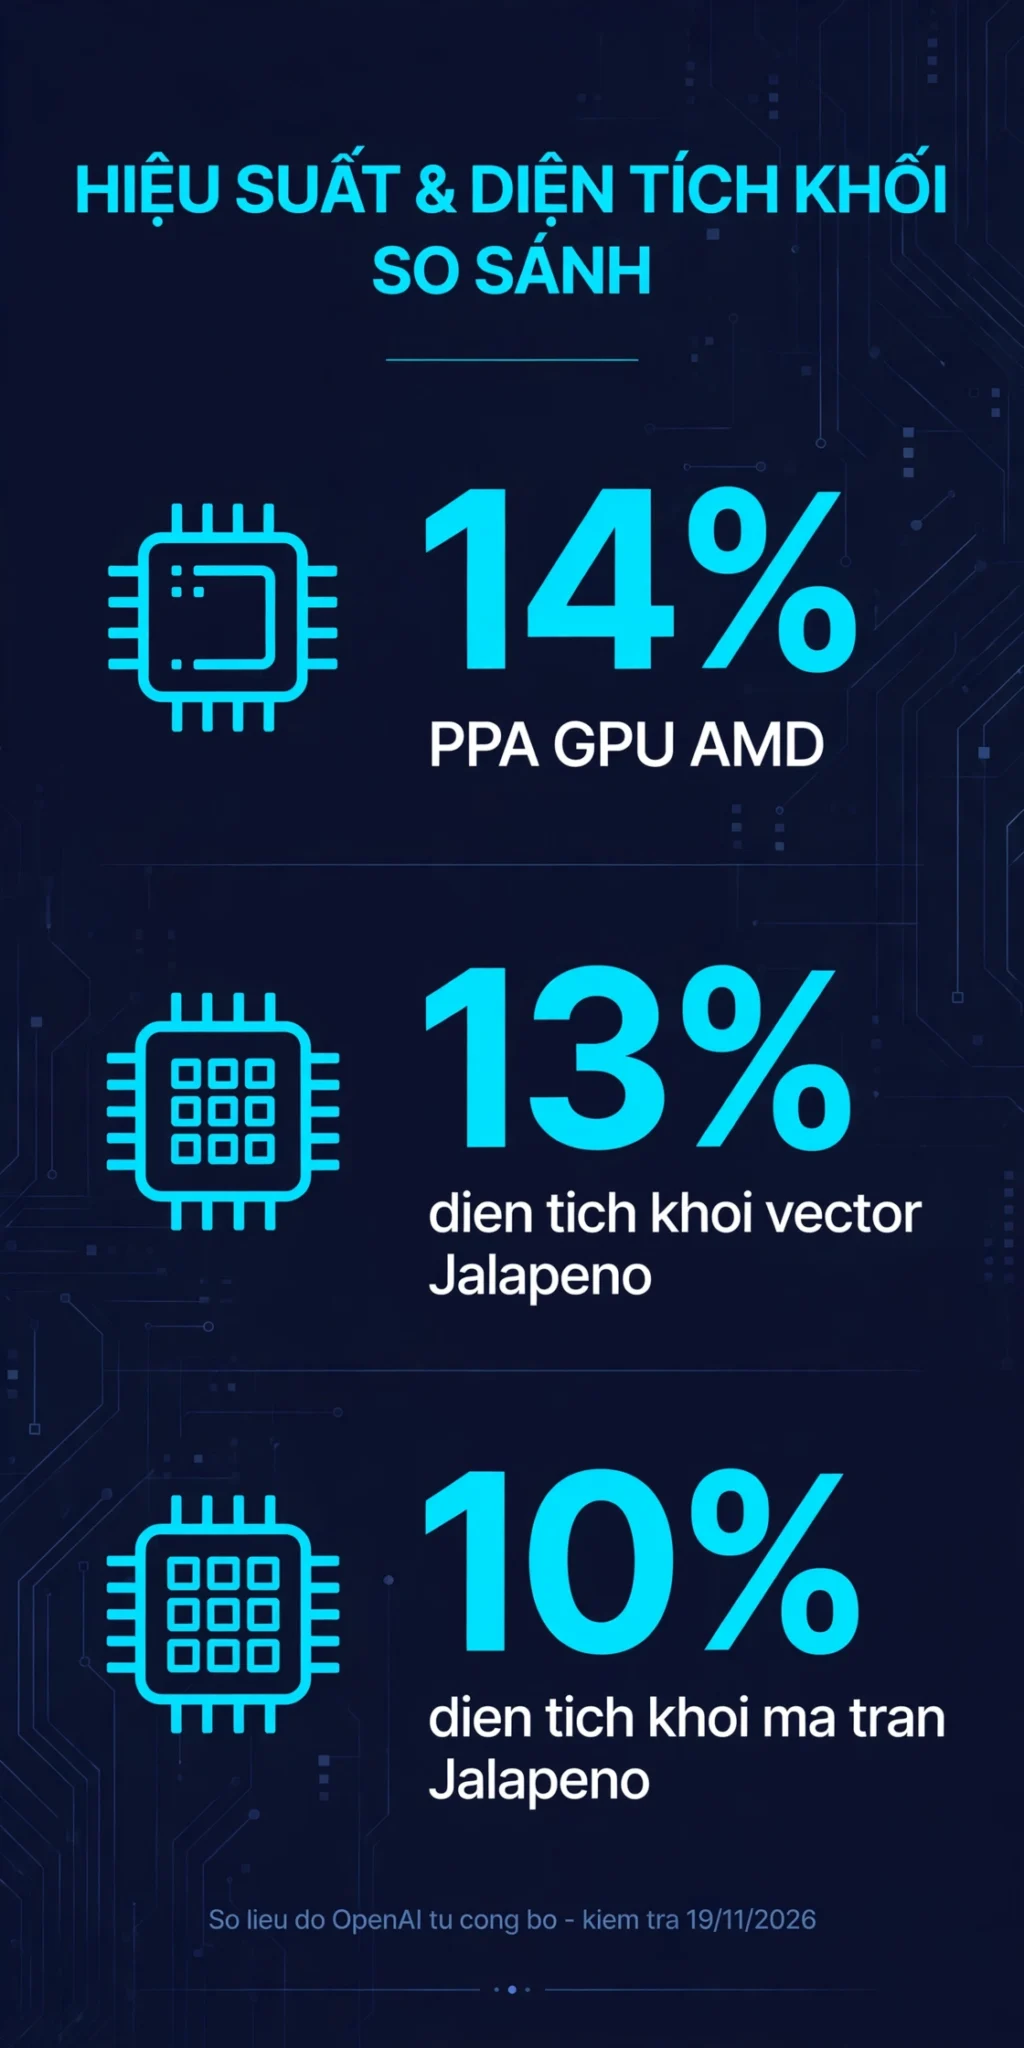
Ba con số hay được trích dẫn nhất từ bài công bố rất dễ bị hiểu sai nếu tách khỏi ngữ cảnh. Bảng dưới đây đặt chúng đúng chỗ:
| Hạng mục | Con số | Ý nghĩa đúng | Mức xác minh |
|---|---|---|---|
| GPU flagship AMD | Tới 14% PPA | Cải thiện tổng hợp hiệu năng – điện năng – diện tích trên một số khối mạch, so với thiết kế đã tối ưu kỹ | AMD xác minh và đưa một phần vào sản xuất |
| CPU flagship AMD thế hệ sau | Một con số % | Cải thiện PPA trên các khối chính, không công bố con số cụ thể | AMD xác minh |
| Chip Jalapeño, khối vector | Giảm khoảng 13% diện tích cell chuẩn | Khối xử lý song song nhỏ lại, tiết kiệm diện tích silicon | Đã kiểm chứng trên chip thật khi bring-up |
| Chip Jalapeño, khối ma trận | Giảm khoảng 10% diện tích cell chuẩn | Khối tính toán ma trận nhỏ lại, trong đó một bộ nhân giảm khoảng 15% diện tích và rút độ trễ từ 2 chu kỳ xuống 1 chu kỳ | Đã kiểm chứng trên chip thật khi bring-up |
Ba con số này đều là số liệu do OpenAI tự công bố, chưa có kiểm chứng độc lập. AMD chưa đưa ra tuyên bố riêng nào về công việc này tính đến ngày 19/11/2026, và không có số đo nào trên silicon AMD thành phẩm được công bố. OpenAI cũng không nêu tên sản phẩm GPU hay CPU cụ thể nào sẽ mang các thay đổi này, cũng không nói đề xuất đạt 14% có phải chính là đề xuất được đưa vào sản xuất hay không.
Jalapeño — chip thử nghiệm trước khi chạm tới AMD
Trước khi làm việc với AMD, OpenAI đã thử đúng quy trình này trên chip suy luận tự thiết kế của mình, có tên mã Jalapeño. Đội ngũ bắt đầu dùng GPT-o3 mini hỗ trợ thiết kế Jalapeño từ đầu năm 2025. Ngay cả model đời đầu đó cũng tìm ra những cải tiến đáng kể, và các model mới hơn tiếp tục đào sâu hơn.
Hai ví dụ cụ thể trong bài đăng cho thấy model làm việc ở mức chi tiết nào. Ở khối ma trận, một bộ nhân được viết lại dùng ít hơn khoảng 15% diện tích cell ở bước tổng hợp logic, đồng thời rút độ trễ từ hai chu kỳ xung nhịp xuống còn một. Một bộ cộng khác cũng giảm khoảng 15% diện tích mà vẫn giữ nguyên độ trễ hai chu kỳ. Cộng dồn toàn bộ thay đổi, OpenAI ước tính diện tích cell chuẩn giảm khoảng 13% ở khối vector và khoảng 10% ở khối ma trận. Điểm khác biệt so với phần AMD: những con số này đã được kiểm chứng trên chip thật trong quá trình bring-up — giai đoạn bật chip lần đầu và đo đạc thực tế.
Jalapeño được OpenAI công bố lần đầu ngày 25/8/2026, phát triển cùng Broadcom, và đi từ thiết kế ban đầu tới tape-out — bước bàn giao thiết kế cho nhà máy — trong chín tháng. OpenAI cho biết dự định bắt đầu chạy Jalapeño trong các trung tâm dữ liệu của mình vào cuối năm 2026. Con chip này quan trọng vì nó là “sân tập” cho toàn bộ phương pháp: nếu model chỉ tối ưu tốt trên giấy mà hỏng trên silicon thật, câu chuyện với AMD đã không xảy ra.
Bài kiểm tra RISC-V: model nào thiết kế chip giỏi nhất
Để đo khả năng thiết kế chip của từng thế hệ model một cách có thể so sánh, OpenAI chạy một bài đánh giá riêng trên hai lõi vi xử lý mã nguồn mở 32-bit thuộc kiến trúc RISC-V: PicoRV32, lõi nhỏ gọn cho FPGA, và Ibex, lõi nhúng dùng trong chip bảo mật OpenTitan. Mỗi model được giao hai nhiệm vụ: tối ưu lõi có sẵn để tăng throughput (số lệnh thực thi mỗi giây), và thiết kế lõi mới từ yêu cầu viết sẵn. Tổng cộng 9.881 lượt chạy được chấm điểm, mỗi lượt dùng ngân sách khoảng 112.000 token.
Kết quả: GPT-6.2 Astra đạt điểm trung bình cao nhất trên cả hai lõi ở cùng ngân sách token. GPT-6.1 Sol cũng vượt GPT-5.6 Sol trên cả hai. Đây là chi tiết đáng chú ý với người theo dõi dòng model mới của OpenAI, vì GPT-6.2 Astra vừa ra mắt tối 18/11 và cũng là model được nhắc tới nhiều nhất trong các bài so sánh model tuần này.
Chính OpenAI cũng chỉ ra một điểm yếu của bài kiểm tra: khi thiết kế từ yêu cầu viết sẵn, cả năm model đều đạt điểm cao hơn khi cải tiến lõi có sẵn. Lý do là model có thể lược bỏ những tính năng ít ảnh hưởng tới throughput trong bài kiểm tra — ví dụ bộ đếm hiệu năng (performance counters) hay một số lệnh phụ — nhưng lại cần thiết trong sản phẩm thật. OpenAI thừa nhận rằng việc bắt buộc giữ lại các tính năng đó, siết giới hạn diện tích và kiểm tra thời gian sau bước tổng hợp vật lý sẽ khiến bài kiểm tra sát với thiết kế chip sản xuất hơn. Nói thẳng: điểm số RISC-V cho thấy model ngày càng giỏi thiết kế mạch, nhưng chưa phải bằng chứng rằng model đã thay thế được kỹ sư trong mọi khâu.
GPT-Synopsys — bước tiếp theo: model dùng công cụ như kỹ sư thật
Phần cuối bài công bố hé lộ hướng đi tiếp theo. Ngày 30/9/2026, OpenAI và Synopsys ký thỏa thuận hợp tác đa năm để cùng phát triển GPT-Synopsys, một model chuyên biệt cho thiết kế chip, có thể vận hành trực tiếp các công cụ EDA của Synopsys “như kỹ sư chip chuyên nghiệp”. OpenAI sẽ cấp phép dùng công cụ EDA của Synopsys để huấn luyện model này, hai bên chia sẻ doanh thu và cùng đưa sản phẩm ra thị trường.
Ý nghĩa thực tế: hiện tại model OpenAI làm việc với chip qua một vòng lặp do đội ngũ tự xây — model đề xuất, công cụ kiểm chứng. GPT-Synopsys hướng tới việc model tự lái được cả chuỗi công cụ thiết kế và kiểm tra mà kỹ sư dùng hằng ngày, từ thiết kế tới xác minh. Theo thông cáo chung, model sẽ chạy trên hạ tầng do OpenAI vận hành, tích hợp với nền tảng Synopsys.ai và Synopsys Autopilot, dữ liệu thiết kế của khách hàng không dùng để huấn luyện model và được mã hóa khi lưu trữ lẫn truyền tải. Chưa có ngày phát hành hay giá công khai.
Nếu GPT-Synopsys thành hình đúng như mô tả, nó sẽ biến “AI hỗ trợ thiết kế chip” từ một dự án nghiên cứu nội bộ của OpenAI thành công cụ thương mại mà bất kỳ hãng chip nào cũng có thể mua. Đó cũng là lúc câu hỏi về vai trò của kỹ sư thiết kế chip trở nên cụ thể hơn nhiều: không phải model có thay kỹ sư không, mà là kỹ sư nào biết dùng model sẽ làm nhanh hơn kỹ sư không dùng.
Giới hạn xác minh: những gì chưa ai chứng minh được
Một bài tin công nghệ có trách nhiệm phải tách rõ phần đã xác minh và phần chưa. Với câu chuyện này, danh sách chưa xác minh còn dài:
- Toàn bộ số liệu do OpenAI tự báo cáo. 14% PPA, 13% và 10% diện tích, “một năm tiến bộ trong chưa đầy 5 tháng” — tất cả đều từ bài đăng của OpenAI. Không có bên độc lập nào đo lại, AMD cũng chưa công bố số liệu riêng tính đến ngày 19/11/2026.
- Không có số đo trên silicon AMD thành phẩm. Các thay đổi mới ở giai đoạn “đưa vào thiết kế gửi đi sản xuất”. Chưa ai biết chúng chạy ra sao trên chip thật, vì chip đó còn chưa xuất xưởng.
- Không nêu tên sản phẩm. OpenAI chỉ nói “GPU flagship” và “CPU flagship thế hệ tiếp theo”, không gắn với dòng sản phẩm cụ thể nào của AMD. Người dùng không thể biết card đồ họa hay CPU nào sẽ hưởng lợi.
- 14% là con số “tới”, không phải trung bình. Đây là mức cải thiện tốt nhất ghi nhận được trên một số khối mạch, không phải mức cải thiện chung của cả con chip. Phần lớn các khối khác có thể cải thiện ít hơn nhiều, hoặc không cải thiện.
- Bài kiểm tra RISC-V có điểm mù. Chính OpenAI thừa nhận model có thể lược bỏ tính năng để tăng điểm, và thời gian chưa được kiểm tra sau bước tổng hợp vật lý.
Những giới hạn này không làm câu chuyện mất giá trị — việc AMD đưa mã do model viết vào sản xuất đã là một cột mốc thật. Nhưng chúng quyết định cách đọc tin: đây là bước tiến lớn của AI trong thiết kế chip, chưa phải bằng chứng rằng GPU sắp tới của AMD sẽ mạnh hơn 14% hay rẻ hơn 14%.
Tác động tới ngành thiết kế chip
Với các hãng chip, ý nghĩa trực tiếp nhất là thời gian. Thiết kế một con chip flagship mất nhiều năm, trong đó khâu tối ưu PPA ở từng khối mạch chiếm phần lớn thời gian của đội ngũ kỹ sư giỏi nhất. Nếu model có thể làm phần việc này nhanh hơn mà vẫn qua được kiểm chứng bằng công cụ chuẩn, chu kỳ phát triển chip có thể rút ngắn đáng kể — và đó là lợi thế cạnh tranh thật trong cuộc đua AI, nơi NVIDIA đang dẫn đầu về cả phần cứng lẫn phần mềm.
Với AMD, câu chuyện còn có ý nghĩa chiến lược. Hãng vừa trải qua một quý mà mảng trung tâm dữ liệu tăng trưởng mạnh, nhưng vẫn bị đặt câu hỏi về khả năng bắt kịp NVIDIA ở phân khúc AI cao cấp. Việc model OpenAI cải thiện được thiết kế GPU của AMD không chỉ giúp sản phẩm tốt hơn, mà còn củng cố quan hệ đối tác với chính khách hàng lớn nhất của mình: OpenAI. Hai bên đang gắn với nhau cả ở phía mua chip lẫn phía thiết kế chip.
Với kỹ sư thiết kế chip, thay đổi đến gần hơn nhiều người tưởng. Công việc viết RTL thủ công cho từng khối mạch khó có thể biến mất — chip vẫn cần người chịu trách nhiệm về kiến trúc tổng thể, về các trường hợp biên mà công cụ kiểm chứng không bao quát hết. Nhưng phần việc “thử hàng chục cách viết lại một khối mạch để tìm ra bản tối ưu nhất” là đúng loại việc mà model làm tốt hơn người: kiên nhẫn, thử nhiều phương án, đo đạc chính xác. Kỹ sư biết dùng model để làm phần đó sẽ đi nhanh hơn kỹ sư chỉ làm tay.
Với người dùng cuối — người mua card đồ họa, người thuê GPU trên cloud, người dùng các dịch vụ AI — tác động chưa thấy ngay. Các thay đổi này nằm trong thiết kế chưa xuất xưởng, và hiệu quả cuối cùng còn phụ thuộc vào nhiều khâu khác: tiến trình sản xuất, phần mềm điều khiển, giá thành. Điều thực tế hơn để chờ đợi là chu kỳ ra mắt chip có thể rút ngắn, và các hãng nhỏ hơn — những hãng không có đội ngũ hàng trăm kỹ sư thiết kế chip — có thể nhờ model mà làm được những việc trước đây chỉ hãng lớn làm nổi.
Những mốc cần theo dõi tiếp
Ba mốc sẽ cho biết câu chuyện này đi xa tới đâu. Thứ nhất, AMD có lên tiếng xác nhận hay công bố thêm chi tiết không — một tuyên bố riêng từ AMD sẽ có trọng lượng hơn nhiều so với bài đăng một phía của OpenAI. Thứ hai, GPT-Synopsys khi nào có bản dùng thử công khai và kết quả đo được trên khách hàng thật ra sao. Thứ ba, khi GPU và CPU mang các thay đổi này ra mắt, số đo hiệu năng thực tế có phản ánh phần nào mức cải thiện PPA mà OpenAI công bố hay không.
Cho tới lúc đó, cách đọc đúng nhất về tin này là: AI đã viết mã mạch đủ tốt để một hãng chip lớn đưa vào sản xuất — một cột mốc thật, với những con số vẫn cần được kiểm chứng thêm trên silicon thành phẩm.
Đọc thêm
- GPT-6.2 là gì? So sánh GPT-6.2 Astra vs Sol và có nên nâng cấp không
- NVIDIA từ chối Huang quay lại: AI mở (Nemotron, Hugging Face) sẽ đi về đâu?
- Gemini 4 Neon là gì? So sánh Neon vs Carbon vs Hydrogen và có nên dùng để code không
Nguồn: OpenAI, “Advancing chip design with OpenAI models”, 18/11/2026 (openai.com); Synopsys, “OpenAI and Synopsys Announce GPT-Synopsys”, 30/9/2026 (news.synopsys.com). Số liệu trong bài đã kiểm tra lại từ nguồn gốc và kiểm chứng chéo qua các bản tin độc lập ngày 19/11/2026. Các con số 14%, 13%, 10% là số liệu do OpenAI tự công bố, chưa có kiểm chứng độc lập; AMD chưa đưa ra tuyên bố riêng tính đến thời điểm kiểm tra.
Bạn nghĩ kỹ sư thiết kế chip nên bắt đầu học dùng AI hỗ trợ thiết kế từ đâu — học viết prompt cho model, hay học cách kiểm chứng mã RTL do model viết ra?
