 Dai Hoang
Table of Contents
Laptop không card rời vẫn chạy được AI offline, miễn là chọn đúng model. LFM3-1.7B của Liquid AI chỉ tốn khoảng 1 GB RAM ở bản lượng tử 4-bit, còn các model 1–4B quen thuộc như Qwen3, Gemma 3 hay Llama 3.2 đều có bản chạy vừa laptop 8 GB. Bài này xếp model theo đúng lượng RAM máy bạn đang có, để khỏi tải về rồi mới biết máy không kham nổi.
Tôi đã từng hí hửng tải một model 7B về chiếc laptop 8 GB RAM, nghĩ rằng cứ có model là chạy. Máy ì ra, quạt rú lên, mỗi câu trả lời chờ cả phút. Lỗi không nằm ở chiếc laptop, mà ở chỗ tôi chọn model theo tên tuổi chứ không theo RAM. Từ lần đó, mỗi khi ai hỏi máy yếu có chạy được AI local không, tôi luôn bắt đầu từ một con số duy nhất: máy còn trống bao nhiêu RAM.
Vì sao máy yếu vẫn chạy được AI, và giới hạn thật nằm ở đâu
Bí quyết nằm ở lượng tử hóa: model gốc lưu mỗi trọng số bằng số 16-bit, bản lượng tử 4-bit (Q4_K_M) nén còn khoảng 4,5 bit, file model nhỏ còn chừng một phần tư mà chất lượng chỉ giảm ít. GGUF là định dạng file của dự án llama.cpp, được Ollama và LM Studio dùng chung, nên cùng một file model chạy được bằng nhiều công cụ.
Công thức tính RAM rất đơn giản: RAM ≈ số tham số × số bit mỗi trọng số / 8, cộng thêm bộ nhớ đệm ngữ cảnh (KV cache). Ví dụ model 8B ở Q4_K_M tốn khoảng 4,6 GB cho trọng số, cộng 1 GB KV cache với ngữ cảnh 8.000 token — và KV cache phình theo độ dài hội thoại, nên model chạy ngon lúc đầu rồi chậm dần khi chat quá dài.
CPU không phải vấn đề chính: model 1–4B chạy bằng CPU laptop vẫn cho 15–100 token mỗi giây, đủ nhanh để đọc kịp; card rời chỉ làm mọi thứ nhanh hơn chứ không phải điều kiện bắt buộc. Laptop 8 GB RAM sau khi trừ hệ điều hành (2,5–3,5 GB) chỉ còn trống khoảng 4,5–5,5 GB — đó mới là ngân sách thật của bạn.
LFM3-1.7B: model 1,7 tỉ tham số nhưng được huấn luyện để làm agent
Nhân vật đáng chú ý nhất trong đợt model mở mùa thu 2026 là LFM3-1.7B của Liquid AI: 1,73 tỉ tham số, kiến trúc tri-hybrid (13 lớp tích chập ngắn, 5 lớp sliding-window attention, 6 lớp global attention), ngữ cảnh 256.000 token, huấn luyện trên 22 nghìn tỉ token, hỗ trợ 16 ngôn ngữ trong đó có tiếng Việt, giấy phép LFM Open License v1.0.
Điểm khiến LFM3 khác các model nhỏ khác là nó được post-training riêng cho việc làm agent: chạy được trong các harness như Hermes Agent, Pi và OpenClaw, gọi tool và trả output có cấu trúc. Số liệu do Liquid AI công bố: gọi hàm BFCL V4 đạt 71,39 điểm, ToolSandbox 80,36, IFEval 96,66, SWE-bench Verified 43,40 — ngang hoặc hơn nhiều model 4–9B ở các bài đo agent, dù kiến thức thuần túy vẫn thua model lớn. Nhóm MacPaw thử 65 tác vụ agent thật trên macOS cũng ghi nhận LFM3 đạt 64% thành công so với 48% của Qwen3.5-2B, dùng ít hơn 58% token và gần như không bị kẹt.
Về RAM, LFM3 thuộc nhóm tiết kiệm nhất hiện nay: bản 4-bit chỉ tốn khoảng 1 GB, KV cache cho ngữ cảnh 128.000 token chỉ 1,6 GB (Qwen3.5-4B cần tới 4,3 GB), tốc độ giải mã nhanh hơn 1,8–2,8 lần model đem so sánh ở ngữ cảnh 32.000 token. Đây là model nhỏ hiếm hoi vừa nhẹ, vừa đủ khôn để giao việc agent thật thay vì chỉ chat cho vui.
Muốn chạy LFM3, bạn cần bản build llama.cpp có hỗ trợ kiến trúc này (model card trên Hugging Face ghi rõ), hoặc bản ONNX qua Transformers.js. Với Ollama thì ở thời điểm viết chưa phải lựa chọn chắc chắn — muốn chạy ngay bằng một lệnh, hãy chọn model đã có sẵn trong thư viện Ollama ở bảng dưới. Còn nếu thích vọc agent, LFM3 là model nhỏ đáng thử nhất lúc này, nhất là khi nó được huấn luyện riêng để chạy trong OpenClaw. Số liệu trong bài kiểm tra ngày 22/11/2026 trên blog chính thức của Liquid AI và trang model LFM3-1.7B trên Hugging Face.
Bảng chọn model theo đúng RAM máy bạn đang có
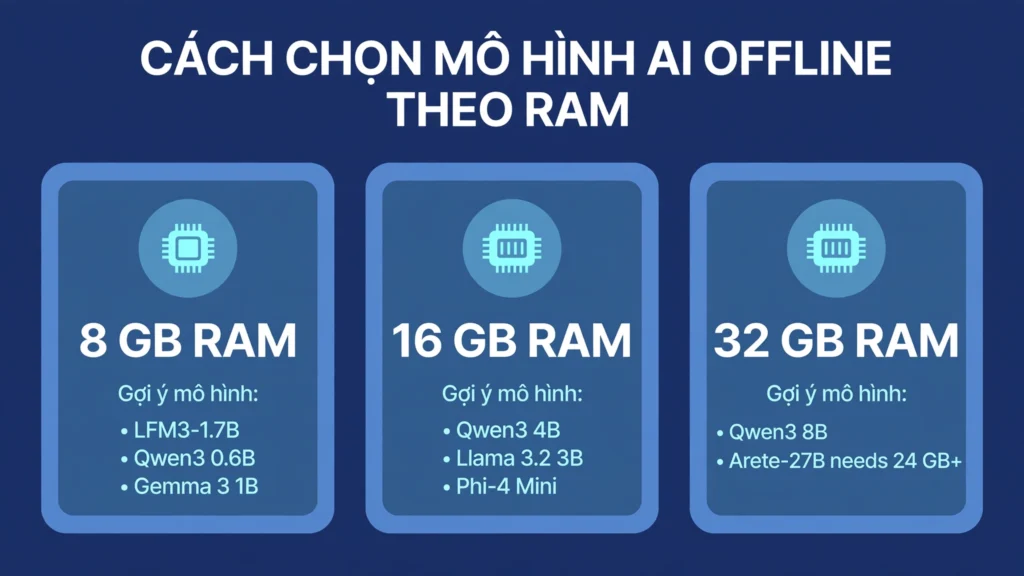
Nguyên tắc chỉ có một: file model cộng KV cache phải nhỏ hơn RAM trống, và luôn chừa chỗ cho hệ điều hành. Bảng dưới xếp theo RAM trống thực tế.
| RAM trống | Model gợi ý | File Q4 | Tốc độ CPU* | Việc hợp nhất |
|---|---|---|---|---|
| ~4 GB (laptop 8 GB) | Qwen3 0.6B | 0,6 GB | ~100 token/giây | Ghi chú, dịch ngắn |
| ~4 GB (laptop 8 GB) | LFM3-1.7B | ~1 GB | Rất nhanh** | Agent nhỏ, gọi tool |
| ~4 GB (laptop 8 GB) | Gemma 3 1B | 0,9 GB | ~60 token/giây | Chat ngắn, trích xuất |
| ~4 GB (laptop 8 GB) | Llama 3.2 1B | 1,0 GB | ~50 token/giây | Chat cơ bản |
| ~8 GB (laptop 16 GB) | Llama 3.2 3B | 3,0 GB | ~19 token/giây | Chat dài, viết nháp |
| ~8 GB (laptop 16 GB) | Phi-4 Mini 3.8B | 3,2 GB | ~16 token/giây | Code đơn giản |
| ~8 GB (laptop 16 GB) | Qwen3 4B | 3,7 GB | ~15 token/giây | Chat chắc tay, code nhẹ |
| ~8 GB (laptop 16 GB) | Gemma 3 4B | 4,7 GB | ~14 token/giây | Chat đa ngữ |
| ~16 GB (laptop 32 GB) | Qwen3 8B | ~6,4 GB | Chậm hơn, vẫn dùng được | Việc nặng, code khó hơn |
| 24 GB trở lên | Arete-27B (Q4_K_M) | 17,2 GB | Cần máy mạnh | Đừng cố trên laptop yếu |
* Tốc độ CPU đo độc lập tháng 11/2026 trên laptop CPU thường, ngữ cảnh 8K. ** LFM3 chưa có số đo cùng điều kiện, hãng công bố nhanh hơn 1,8–2,8 lần.
Arete-27B: ví dụ cho thấy ranh giới nằm ở đâu
Không phải model mở nào ra mắt cuối 2026 cũng dành cho laptop yếu, và Arete-27B là ví dụ rõ nhất. Nous Research phát hành ngày 6/11/2026, fine-tune từ Qwen3.8-27B, 27,36 tỉ tham số, giấy phép Apache 2.0, ngữ cảnh 256.000 token. Bản GGUF phổ biến (bartowski, AtomicChat) có file Q4_K_M nặng 17,2 GB, cộng khoảng 0,5 GB KV cache với ngữ cảnh 8.000 token — tổng khoảng 17,7 GB; bản nén sâu nhất IQ2_XXS còn 8,6 GB, bản Q8_0 lên tới 28,7 GB.
Thực tế là laptop 16 GB chỉ chạy được bản IQ3_S với ngữ cảnh ngắn, và phải kiên nhẫn chờ từng chữ. Muốn chạy Arete-27B thoải mái, bạn cần máy 24–32 GB RAM hoặc card đồ họa 24 GB VRAM. Điểm mạnh của Arete không nằm ở kích thước mà ở cách fine-tune “value-tuned”: điểm sự thật theo đánh giá của Nous tăng từ 2,32 lên 2,98 trên 5, còn tỉ lệ câu trả lời mang khung của nhà nước Trung Quốc giảm từ 22% xuống 0,9%. Bài học rất thực dụng: đừng cố nhét model lớn vào máy yếu bằng cách nén sâu — chất lượng rơi nhanh hơn dung lượng tiết kiệm được, và model nhỏ chạy trọn trong RAM luôn nhanh, ổn định hơn model lớn bị chia nửa sang CPU rồi tràn ra ổ đĩa.
Chạy thử trong 10 phút với Ollama
Cách nhanh nhất để bắt đầu là Ollama. Bước một, tải Ollama từ trang chủ và cài như phần mềm bình thường. Bước hai, mở terminal và gõ ollama run qwen3:4b nếu máy 16 GB RAM, hoặc ollama run llama3.2:1b nếu máy chỉ có 8 GB — lệnh tự tải model về (bản Qwen3 0.6B chỉ nặng 522 MB) rồi mở khung chat ngay trong terminal. Bước ba, thử vài việc thật: tóm tắt một đoạn văn bản, viết lại email, giải thích một đoạn code, rồi mới quyết định có giữ model đó không.
Không thích gõ lệnh thì dùng LM Studio: tải file GGUF từ Hugging Face về, kéo thả vào ứng dụng là chạy, có sẵn giao diện chat. Muốn chắc chắn dữ liệu không rời khỏi máy, đặt biến môi trường OLLAMA_NO_CLOUD=1 để Ollama chạy hoàn toàn local. Tải model từ repo chính chủ trên Hugging Face (LiquidAI, Qwen, Google, Meta) hoặc các bản GGUF uy tín như bartowski — tránh file trôi nổi không rõ nguồn, vì file model chạy thẳng trên máy bạn. Nếu việc cần model lớn hơn mà máy không kham nổi, API miễn phí là phương án dự phòng: tôi đã tổng hợp các API AI miễn phí cho dân dev năm 2026 kèm giới hạn thật từng nhà — dùng cloud cho việc nặng, local cho việc riêng tư.
Việc gì làm được, việc gì chưa
Model nhỏ offline làm tốt: tóm tắt tài liệu, viết nháp email và bài đăng, trích xuất thông tin từ văn bản dài, giải thích code, dịch đoạn ngắn, và chạy agent nhỏ làm việc lặt vặt như tra cứu file hay gọi tool — nhất là với LFM3. Chúng cũng hợp lý cho dữ liệu nhạy cảm, vì mọi thứ xử lý ngay trên máy bạn, không gửi lên server nào.
Ngược lại, đừng giao cho model nhỏ: code tính năng phức tạp, toán khó, kiến thức sau ngày model được huấn luyện (model không tự cập nhật tin tức), và hội thoại dài hàng chục nghìn token trên máy yếu vì KV cache phình ra làm tốc độ tụt mạnh. Model càng nhỏ càng dễ bịa: một bài đo thực tế ghi lại cảnh Qwen3 0.6B trả lời sai ngay câu hỏi “GGUF là gì”, bảo đó là định dạng file đồ họa 3D. Dưới 1B chỉ nên dùng cho việc lặt vặt, đừng giao việc cần chính xác.
Về tiếng Việt, LFM3, Qwen3 và Gemma 3 đều hỗ trợ, nhưng model nhỏ viết tiếng Việt dài vẫn dễ lạc đề — để model viết nháp rồi bạn kiểm tra lại, đừng copy nguyên văn đem đăng. Muốn nối model local vào quy trình tự động, bài tạo AI Agent bằng n8n trên site này là điểm bắt đầu phù hợp, chỉ cần thay model cloud bằng endpoint local.
Ba lưu ý trước khi tải model về
Thứ nhất, giấy phép: Qwen3 và Arete-27B dùng Apache 2.0, thoải mái cả thương mại; LFM3 dùng LFM Open License v1.0; Gemma 3 theo điều khoản riêng của Google; Llama 3.2 theo Llama Community License. Đọc kỹ trước khi dùng model trong sản phẩm bán cho khách, đừng mặc định mọi model mở đều dùng tự do như nhau.
Thứ hai, model không biết tin mới: mọi model trong bài đều có ngày cắt kiến thức, nên đừng hỏi tin tức hay giá cả hiện tại rồi thất vọng khi câu trả lời sai. Việc cần dữ liệu tươi vẫn thuộc về công cụ cloud.
Thứ ba, dung lượng ổ đĩa: model 27B bản Q4 đã 17 GB, bản gốc 16-bit hơn 50 GB — kiểm tra ổ trống trước khi tải. Model nhỏ có một ưu điểm ít ai nhắc: LFM3-1.7B chỉ khoảng 1 GB, tải về trong phút mốt, xóa đi cũng không tiếc, nên cứ thử vài model rồi giữ lại model hợp tay nhất.
Chạy AI offline trên laptop không card rời không còn là trò thử cho vui. Với model 1–4B chọn đúng RAM, bạn có một trợ lý riêng tư, không tốn phí API, chạy được cả khi mất mạng. Bắt đầu từ LFM3-1.7B nếu thích vọc agent, hoặc Qwen3 4B nếu cần model chat chắc tay — và nhớ đo RAM trống trước khi tải bất cứ thứ gì về.
Laptop của bạn có bao nhiêu RAM, và bạn đã thử chạy model nào offline rồi — tốc độ thực tế có đúng như bảng trên không?
